
Search K
Appearance
智能体(Agent)就是能感知环境、自己做决定、还能动手做事、奔着目标去的实体。 包含4个关键部分:
一句话总结:感知 → 思考 → 行动 → 达成目标,形成一个闭环。
简单反射智能体 只有“如果…就…”规则,没记忆、不思考。 例子:空调、恒温器、烟雾报警器。
基于模型的反射智能体 有一点“记忆/内部地图”,看不见的东西也能推断。 例子:进隧道看不见前车,自动驾驶依然知道车在前面。
基于目标的智能体 有明确目标,会规划路径。 例子:GPS导航、快递路线规划。
基于效用的智能体 会权衡利弊,选“最划算、最满意”方案。 例子:又快又便宜又不堵的导航。
学习型智能体 自己从经验里学习,越做越好。 例子:AlphaGo、会进化的下棋AI。
和传统智能体的区别:
例子:你说“规划厦门旅行”,它自己查天气、查景点、订酒店、改预算。

按决策方式 反射型(快、无脑)、规划型(慢、想得多)、混合型(兼顾快慢)
按知识表示
用来标准化定义一个智能体该干什么、在什么环境干、用什么干:
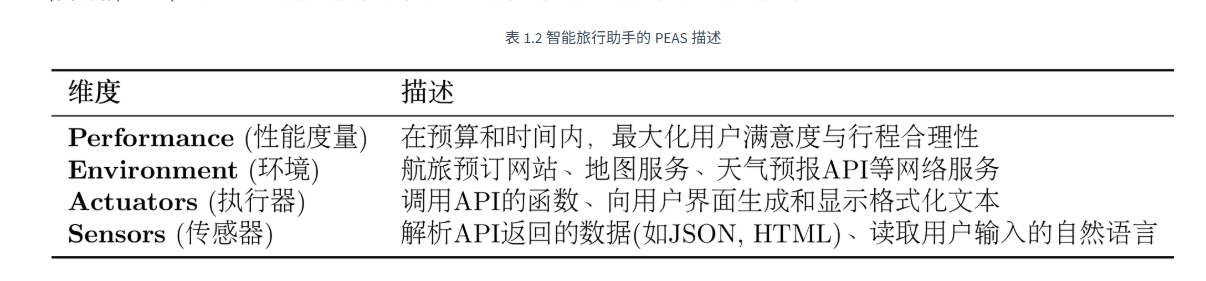
例子:智能旅行助手
智能体并非一次性完成任务,而是通过一个持续的循环与环境进行交互,这个核心机制被称为 智能体循环 (Agent Loop)。
感知 → 思考 → 行动 → 观察 → 循环
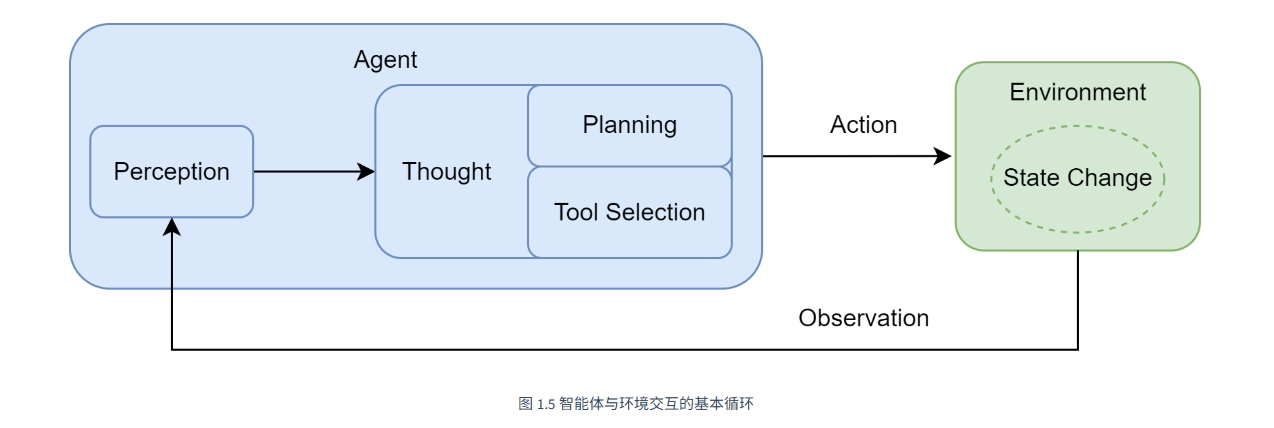
每一步都输出固定格式:
Thought: 我现在要做什么、为什么
Action: 调用什么工具(参数="xxx")
Observation: 工具返回的结果
例如,一个正在规划旅行的智能体可能会生成如下格式化的输出:
Thought: 用户想知道北京的天气。我需要调用天气查询工具。
Action: get_weather("北京")
行动执行后,环境会返回一个结果。例如,get_weather函数可能返回一个包含详细天气数据的 JSON 对象。然而,原始的机器可读数据(如 JSON)通常包含 LLM 无需关注的冗余信息,且格式不符合其自然语言处理的习惯。因此,感知系统的一个重要职责就是扮演传感器的角色:将这个原始输出处理并封装成一段简洁、清晰的自然语言文本,即观察。
Observation: 北京当前天气为晴,气温25摄氏度,微风。这段Observation文本会被反馈给智能体,作为下一轮循环的主要输入信息,供其进行新一轮的Thought和Action。
综上所述,通过这个由 Thought、Action、Observation 构成的严谨循环,LLM 智能体得以将内部的语言推理能力,与外部环境的真实信息和工具操作能力有效地结合起来。
为了能从 Python 程序中访问网络 API,我们需要一个 HTTP 库。requests 是 Python 社区中最流行、最易用的选择。tavily-python 是一个强大的 AI 搜索 API 客户端,用于获取实时的网络搜索结果,可以在官网注册后获取 API。openai 是 OpenAI 官方提供的 Python SDK,用于调用 GPT 等大语言模型服务。请先通过以下命令安装它们:
pip install requests tavily-python openaiAGENT_SYSTEM_PROMPT = """
你是一个智能旅行助手。你的任务是分析用户的请求,并使用可用工具一步步地解决问题。
# 可用工具:
- `get_weather(city: str)`: 查询指定城市的实时天气。
- `get_attraction(city: str, weather: str)`: 根据城市和天气搜索推荐的旅游景点。
# 输出格式要求:
你的每次回复必须严格遵循以下格式,包含一对Thought和Action:
Thought: [你的思考过程和下一步计划]
Action: [你要执行的具体行动]
Action的格式必须是以下之一:
1. 调用工具:function_name(arg_name="arg_value")
2. 结束任务:Finish[最终答案]
# 重要提示:
- 每次只输出一对Thought-Action
- Action必须在同一行,不要换行
- 当收集到足够信息可以回答用户问题时,必须使用 Action: Finish[最终答案] 格式结束
请开始吧!
"""我们将使用免费的天气查询服务 wttr.in,它能以 JSON 格式返回指定城市的天气数据。下面是实现该工具的代码:
import requests

def get_weather(city: str) -> str:
    """
    通过调用 wttr.in API 查询真实的天气信息。
    """
    # API端点,我们请求JSON格式的数据
    url = f"https://wttr.in/{city}?format=j1"

    try:
        # 发起网络请求
        response = requests.get(url)
        # 检查响应状态码是否为200 (成功)
        response.raise_for_status()
        # 解析返回的JSON数据
        data = response.json()

        # 提取当前天气状况
        current_condition = data['current_condition'][0]
        weather_desc = current_condition['weatherDesc'][0]['value']
        temp_c = current_condition['temp_C']

        # 格式化成自然语言返回
        return f"{city}当前天气:{weather_desc},气温{temp_c}摄氏度"

    except requests.exceptions.RequestException as e:
        # 处理网络错误
        return f"错误:查询天气时遇到网络问题 - {e}"
    except (KeyError, IndexError) as e:
        # 处理数据解析错误
return f"错误:解析天气数据失败,可能是城市名称无效 - {e}"它会根据城市和天气状况,在互联网上搜索合适的景点
import os
from tavily import TavilyClient

def get_attraction(city: str, weather: str) -> str:
    """
    根据城市和天气,使用Tavily Search API搜索并返回优化后的景点推荐。
    """
    # 1. 从环境变量中读取API密钥
    api_key = os.environ.get("TAVILY_API_KEY")
    if not api_key:
        return "错误:未配置TAVILY_API_KEY环境变量。"

    # 2. 初始化Tavily客户端
    tavily = TavilyClient(api_key=api_key)

    # 3. 构造一个精确的查询
    query = f"'{city}' 在'{weather}'天气下最值得去的旅游景点推荐及理由"

    try:
        # 4. 调用API,include_answer=True会返回一个综合性的回答
        response = tavily.search(query=query, search_depth="basic", include_answer=True)

        # 5. Tavily返回的结果已经非常干净,可以直接使用
        # response['answer'] 是一个基于所有搜索结果的总结性回答
        if response.get("answer"):
            return response["answer"]

        # 如果没有综合性回答,则格式化原始结果
        formatted_results = []
        for result in response.get("results", []):
            formatted_results.append(f"- {result['title']}: {result['content']}")

        if not formatted_results:
             return "抱歉,没有找到相关的旅游景点推荐。"

        return "根据搜索,为您找到以下信息:\n" + "\n".join(formatted_results)

    except Exception as e:
        return f"错误:执行Tavily搜索时出现问题 - {e}"

# 将所有工具函数放入一个字典,方便后续调用
available_tools = {
    "get_weather": get_weather,
    "get_attraction": get_attraction,
}当前,许多 LLM 服务提供商(包括 OpenAI、Azure、以及众多开源模型服务框架如 Ollama、vLLM 等)都遵循了与 OpenAI API 相似的接口规范。这种标准化为开发者带来了极大的便利。智能体的自主决策能力来源于 LLM。我们将实现一个通用的客户端 OpenAICompatibleClient ,它可以连接到任何兼容 OpenAI 接口规范的 LLM 服务。
from openai import OpenAI

class OpenAICompatibleClient:
    """
    一个用于调用任何兼容OpenAI接口的LLM服务的客户端。
    """
    def __init__(self, model: str, api_key: str, base_url: str):
        self.model = model
        self.client = OpenAI(api_key=api_key, base_url=base_url)

    def generate(self, prompt: str, system_prompt: str) -> str:
        """调用LLM API来生成回应。"""
        print("正在调用大语言模型...")
        try:
            messages = [
                {'role': 'system', 'content': system_prompt},
                {'role': 'user', 'content': prompt}
            ]
            response = self.client.chat.completions.create(
                model=self.model,
                messages=messages,
                stream=False
            )
            answer = response.choices[0].message.content
            print("大语言模型响应成功。")
            return answer
        except Exception as e:
            print(f"调用LLM API时发生错误: {e}")
return "错误:调用语言模型服务时出错。"整个流程如下:
Action是先调用获取天气的工具方法,通过正则从字符串中匹配出Action和对应的方法名和参数,然后就可以直接在代码中进行调用Observation:北京天气 27度,然后将Observation添加到对话组中传入给模型,让模型了解整个对话,继续进行思考和行动北京天气 27度 判断调用搜索景点 API,然后获得结果,再次进行一轮思考import re
# --- 1. 配置LLM客户端 ---
# 请根据您使用的服务,将这里替换成对应的凭证和地址
API_KEY = "YOUR_API_KEY"
BASE_URL = "YOUR_BASE_URL"
MODEL_ID = "YOUR_MODEL_ID"
TAVILY_API_KEY="YOUR_Tavily_KEY"
os.environ['TAVILY_API_KEY'] = "YOUR_TAVILY_API_KEY"
llm = OpenAICompatibleClient(
model=MODEL_ID,
api_key=API_KEY,
base_url=BASE_URL
)
# --- 2. 初始化 ---
user_prompt = "你好,请帮我查询一下今天北京的天气,然后根据天气推荐一个合适的旅游景点。"
prompt_history = [f"用户请求: {user_prompt}"]
print(f"用户输入: {user_prompt}\n" + "="*40)
# --- 3. 运行主循环 ---
for i in range(5): # 设置最大循环次数
print(f"--- 循环 {i+1} ---\n")
# 3.1. 构建Prompt
full_prompt = "\n".join(prompt_history)
# 3.2. 调用LLM进行思考
llm_output = llm.generate(full_prompt, system_prompt=AGENT_SYSTEM_PROMPT)
# 模型可能会输出多余的Thought-Action,需要截断
match = re.search(r'(Thought:.*?Action:.*?)(?=\n\s*(?:Thought:|Action:|Observation:)|\Z)', llm_output, re.DOTALL)
if match:
truncated = match.group(1).strip()
if truncated != llm_output.strip():
llm_output = truncated
print("已截断多余的 Thought-Action 对")
print(f"模型输出:\n{llm_output}\n")
prompt_history.append(llm_output)
# 3.3. 解析并执行行动
action_match = re.search(r"Action: (.*)", llm_output, re.DOTALL)
if not action_match:
observation = "错误: 未能解析到 Action 字段。请确保你的回复严格遵循 'Thought: ... Action: ...' 的格式。"
observation_str = f"Observation: {observation}"
print(f"{observation_str}\n" + "="*40)
prompt_history.append(observation_str)
continue
action_str = action_match.group(1).strip()
if action_str.startswith("Finish"):
final_answer = re.match(r"Finish\[(.*)\]", action_str).group(1)
print(f"任务完成,最终答案: {final_answer}")
break
tool_name = re.search(r"(\w+)\(", action_str).group(1)
args_str = re.search(r"\((.*)\)", action_str).group(1)
kwargs = dict(re.findall(r'(\w+)="([^"]*)"', args_str))
if tool_name in available_tools:
observation = available_tools[tool_name](**kwargs)
else:
observation = f"错误:未定义的工具 '{tool_name}'"
# 3.4. 记录观察结果
observation_str = f"Observation: {observation}"
print(f"{observation_str}\n" + "="*40)
prompt_history.append(observation_str)调用结果:
用户输入: 你好,请帮我查询一下今天北京的天气,然后根据天气推荐一个合适的旅游景点。
========================================
--- 循环 1 ---

正在调用大语言模型...
大语言模型响应成功。
模型输出:
Thought: 首先需要获取北京今天的天气情况,之后再根据天气情况来推荐旅游景点。
Action: get_weather(city="北京")

Observation: 北京当前天气:Sunny,气温26摄氏度
========================================
--- 循环 2 ---

正在调用大语言模型...
大语言模型响应成功。
模型输出:
Thought: 现在已经知道了北京今天的天气是晴朗且温度适中,接下来可以基于这个信息来推荐一个适合的旅游景点了。
Action: get_attraction(city="北京", weather="Sunny")

Observation: 北京在晴天最值得去的旅游景点是颐和园,因其美丽的湖景和古建筑。另一个推荐是长城,因其壮观的景观和历史意义。
========================================
--- 循环 3 ---

正在调用大语言模型...
大语言模型响应成功。
模型输出:
Thought: 已经获得了两个适合晴天游览的景点建议,现在可以根据这些信息给用户提供满意的答复。
Action: Finish[今天北京的天气是晴朗的,气温26摄氏度,非常适合外出游玩。我推荐您去颐和园欣赏美丽的湖景和古建筑,或者前往长城体验其壮观的景观和深厚的历史意义。希望您有一个愉快的旅行!]

任务完成,最终答案: 今天北京的天气是晴朗的,气温26摄氏度,非常适合外出游玩。我推荐您去颐和园欣赏美丽的湖景和古建筑,或者前往长城体验其壮观的景观和深厚的历史意义。希望您有一个愉快的旅行!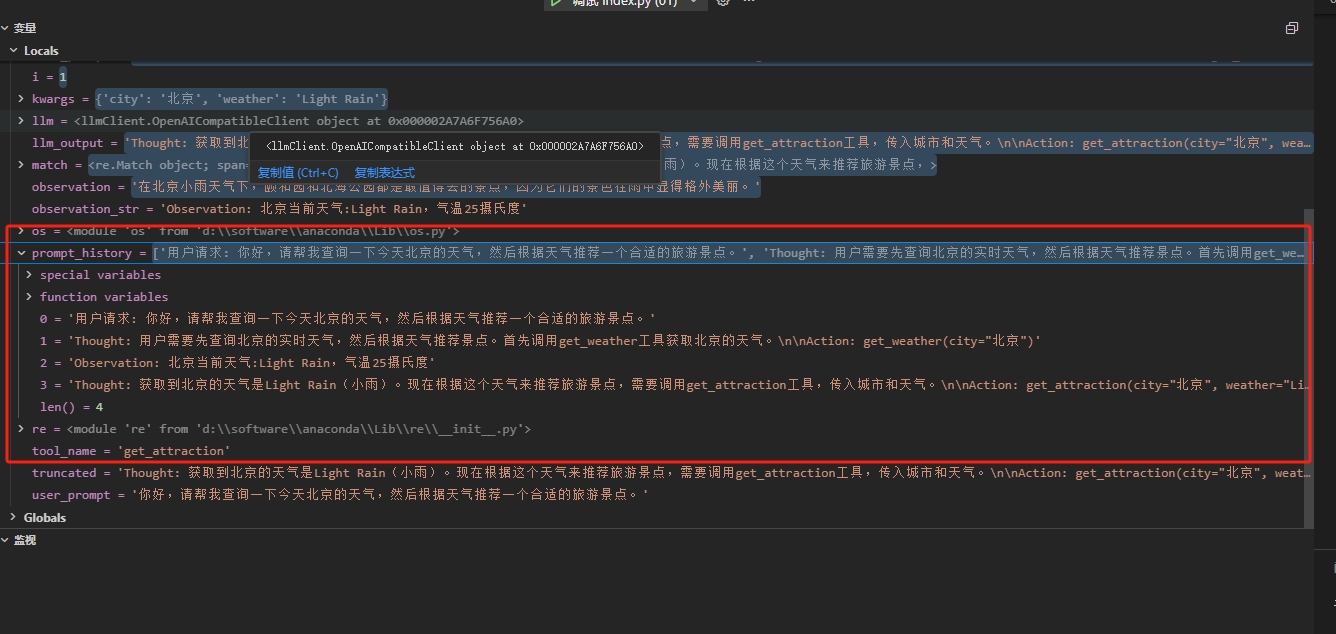
可以debugger看一下prompt_history中的数据,而每次运行一个TAO,都会添加到prompt_history中,然后再作为模型的入参传入,所以模型始终了解历史对话
'用户请求: 你好,请帮我查询一下今天北京的天气,然后根据天气推荐一个合适的旅游景点。'
'Thought: 用户需要先查询北京的实时天气,然后根据天气推荐景点。首先调用get_weather工具获取北京的天气。\n\nAction: get_weather(city="北京")'
'Observation: 北京当前天气:Light Rain,气温25摄氏度'
'Thought: 获取到北京的天气是Light Rain(小雨)。现在根据这个天气来推荐旅游景点,需要调用get_attraction工具,传入城市和天气。\n\nAction: get_attraction(city="北京", weather="Light Rain")
'Observation: 在北京小雨天气下,颐和园和北海公园都是最值得去的景点,因为它们的景色在雨中显得格外美丽。'
'Thought: 已获取天气和景点推荐信息。现在可以整合结果回答用户的问题。\n\nAction: Finish[根据查询,今天北京的天气是小雨,气温25摄氏度。推荐的旅游景点是颐和园和北海公园,它们在雨中景色格外美丽,非常适合游览。]'大语言模型(LLM)是所有现代AI智能体的核心基础,本章通俗易懂地拆解了LLM的进化历程、底层运行逻辑和核心使用技巧,是理解、开发智能体的必备知识。
语言模型的进化,本质是AI语言理解能力的升级,这一章节主要以了解为主
在神经网络出来之前,主力是HMM。 逻辑很简单:一句话是一串词,每个词只和紧挨着的前一个词有关系,靠统计海量文本算出搭配概率。 用途:拼音转汉字、简单机器翻译、语音识别。 短板:只能看相邻词语,长句子完全抓不住整体意思,语序一变就出错。
谷歌提出,抛弃循环结构,核心自注意力:一段文字里每个字可以直接和全文所有字词建立关联,远近内容同等读取。 优势:可以大批量并行训练,能无限放大模型规模;分出两条路线:
HMM统计概率 → LSTM带记忆神经网络 → Transformer革新架构 → GPT1-3堆规模涌现能力 → GPT3.5/4人工对齐变成好用对话AI
大模型不认识我们日常的汉字、词语,只会识别Token(词块)。通过BPE等分词算法,会把完整词语、长单词、生僻词拆分为固定的小块,既精简词汇库,又能适配网络新词、专业术语。同时,大模型的上下文长度、计费标准、运算速度,全部以Token为单位计算。
想要用好LLM,核心在于提示词设计,关键参数和技巧包括:
LLM的核心优势是具备通用语义理解、逻辑推理、内容创作、涌现能力,适配绝大多数通用AI场景,是智能体的绝佳大脑。 但同时存在三大核心短板:容易产生幻觉、编造虚假信息;训练数据固定,知识存在时效性滞后;超长文本场景容易遗漏关键信息。目前行业主流解决方案是通过RAG检索增强、工具调用、自我反思验证等方式,弥补大模型的天生缺陷。
在上一章中,我们深入探讨了作为现代智能体“大脑”的大语言模型。我们了解了其内部的Transformer架构、与之交互的方法,以及它的能力边界。现在,是时候将这些理论知识转化为实践,亲手构建智能体了。
一个现代的智能体,其核心能力在于能将大语言模型的推理能力与外部世界联通。它能够自主地理解用户意图、拆解复杂任务,并通过调用代码解释器、搜索引擎、API等一系列“工具”,来获取信息、执行操作,最终达成目标。 然而,智能体并非万能,它同样面临着来自大模型本身的“幻觉”问题、在复杂任务中可能陷入推理循环、以及对工具的错误使用等挑战,这些也构成了智能体的能力边界。
为了更好地组织智能体的“思考”与“行动”过程,业界涌现出了多种经典的架构范式。在本章中,我们将聚焦于其中最具代表性的三种,并一步步从零实现它们:
ReAct (Reasoning and Acting): 一种将“思考”和“行动”紧密结合的范式,让智能体边想边做,动态调整。Plan-and-Solve: 一种“三思而后行”的范式,智能体首先生成一个完整的行动计划,然后严格执行。Reflection: 一种赋予智能体“反思”能力的范式,通过自我批判和修正来优化结果。了解了这些之后,你可能会问,市面上已有LangChain、LlamaIndex等众多优秀框架,为何还要“重复造轮子”?答案在于,尽管成熟的框架在工程效率上优势显著,但直接使用高度抽象的工具,并不利于我们了解背后的设计机制是怎么运行的,或者是有何好处。其次,这个过程会暴露出项目的工程挑战。框架为我们处理了许多问题,例如模型输出格式的解析、工具调用失败的重试、防止智能体陷入死循环等。亲手处理这些问题,是培养系统设计能力的最直接方式。最后,也是最重要的一点,掌握了设计原理,你才能真正地从一个框架的“使用者”转变为一个智能体应用的“创造者”。当标准组件无法满足你的复杂需求时,你将拥有深度定制乃至从零构建一个全新智能体的能力。
本书的实战部分将主要使用 Python 语言,建议使用 Python 3.10 或更高版本。首先,请确保你已经安装了 openai 库用于与大语言模型交互,以及 python-dotenv 库用于安全地管理我们的 API 密钥。
在你的终端中运行以下命令:
pip install openai python-dotenv为了让我们的代码更通用,我们将模型服务的相关信息(模型ID、API密钥、服务地址)统一配置在环境变量中。
.env file
LLM_API_KEY="sk-xxx"
LLM_MODEL_ID="deepseek-chat"
LLM_BASE_URL="https://api.deepseek.com"
LLM_TIMEOUT=60
SERPAPI_API_KEY="xxxx"HelloAgentsLLM.py
from multiprocessing import context
import os
from dotenv import load_dotenv
from openai import OpenAI
from typing import List, Dict

# 加载环境变量
load_dotenv()

# 初始化LLM客户端
class HelloAgentsLLM:
    """
    用于调用任何兼容OpenAI的LLM API调用客户端,默认响应类型是流式响应
    """
    def __init__(self, model: str=None, apiKey: str=None, baseUrl: str=None, timeout: int=None):
        """
        初始化LLM客户端,model是模型名称,apiKey是API密钥,baseUrl是API地址,timeout是超时时间
        如果没有传入参数则默认使用环境变量中的配置,如果传入了配置则使用传入的配置
        """
        self.model = model or os.getenv("LLM_MODEL_ID")
        apiKey = apiKey or os.getenv("LLM_API_KEY")
        baseUrl = baseUrl or os.getenv("LLM_BASE_URL")
        timeout = timeout or int(os.getenv("LLM_TIMEOUT",60))

        if not all([self.model, apiKey, baseUrl]):
            raise ValueError("model, apiKey, baseUrl are required")

        self.client = OpenAI(api_key=apiKey, base_url=baseUrl, timeout=timeout)

    def think(self,messages: List[Dict[str, str]],temperature: float=0) -> str:
        """
        调用大预言模型进行思考,并返回其响应
        """
        print(f"正在调用 {self.model} 模型...")
        try:
            response = self.client.chat.completions.create(
                model=self.model,
                messages=messages,
                temperature=temperature,
                stream=True
            )

            # 处理流式响应
            print(f"模型响应成功")
            collected_content = []
            for chunk in response:
                if not chunk.choices:
                    continue
                content = chunk.choices[0].delta.content or ""
                print(content, end="", flush=True)
                collected_content.append(content)
            print() # 在流式输出结束以后进行换行
            return "".join(collected_content)


        except Exception as e:
            print(f"调用 {self.model} 模型时发生错误: {e}")
            return f"错误:调用语言模型服务时出错。"
测试示例
from HelloAgentsLLM import HelloAgentsLLM

if __name__ == '__main__':
    try:
        llmClient = HelloAgentsLLM()

        exampleMessages = [
            {"role": "system", "content": "你是一位乌龟养殖专家,请根据用户的问题给出相应的回答"},
            {"role": "user", "content": "我刚买了一只20g的黄缘闭壳龟,它到家需要注意什么,如何操作,我已经准备好了黄缘养殖环境。"}
        ]

        print("--- 调用LLM ---")
        reponseText = llmClient.think(exampleMessages)
        if reponseText:
            print("\n\n --- 完整模型响应 ---")
            print(reponseText)
    except ValueError as e:
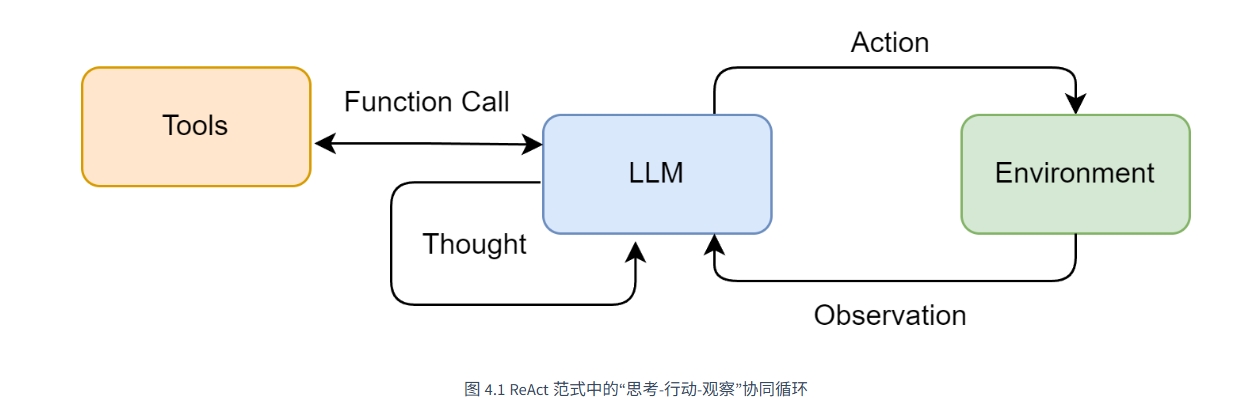
print(f"错误: {e}")在准备好LLM客户端后,我们将构建第一个,也是最经典的一个智能体范式ReAct (Reason + Act)。ReAct由Shunyu Yao于2022年提出[1],其核心思想是模仿人类解决问题的方式,将推理 (Reasoning) 与行动 (Acting) 显式地结合起来,形成一个“思考-行动-观察”的循环。
在ReAct诞生之前,主流的方法可以分为两类:一类是“纯思考”型,如思维链 (Chain-of-Thought),它能引导模型进行复杂的逻辑推理,但无法与外部世界交互,容易产生事实幻觉;另一类是“纯行动”型,模型直接输出要执行的动作,但缺乏规划和纠错能力。
ReAct的巧妙之处在于,它认识到思考与行动是相辅相成的。思考指导行动,而行动的结果又反过来修正思考。为此,ReAct范式通过一种特殊的提示工程来引导模型,使其每一步的输出都遵循一个固定的轨迹:
智能体将不断重复这个 Thought -> Action -> Observation 的循环,将新的观察结果追加到历史记录中,形成一个不断增长的上下文,直到它在Thought中认为已经找到了最终答案,然后输出结果。这个过程形成了一个强大的协同效应:推理使得行动更具目的性,而行动则为推理提供了事实依据。
这种机制特别适用于以下场景:
因此我们将构建一个具备使用外部工具能力的ReAct智能体,来回答一个大语言模型仅凭自身知识库无法直接回答的问题。例如:“华为最新的手机是哪一款?它的主要卖点是什么?” 这个问题需要智能体理解自己需要上网搜索,调用工具搜索结果并总结答案。
如果说大语言模型是智能体的大脑,那么工具 (Tools) 就是其与外部世界交互的“手和脚”。为了让ReAct范式能够真正解决我们设定的问题,智能体需要具备调用外部工具的能力。
针对本节设定的目标——回答关于“华为最新手机”的问题,我们需要为智能体提供一个网页搜索工具。在这里我们选用 SerpApi,它通过API提供结构化的Google搜索结果,能直接返回“答案摘要框”或精确的知识图谱信息。
首先,需要安装该库:
pip install google-search-results官网注册一个免费账户,获取到api-key
# .env file
# ... (保留之前的LLM配置)
SERPAPI_API_KEY="YOUR_SERPAPI_API_KEY"
在下面代码中,首先会检查是否存在 answer_box(Google的答案摘要框)或 knowledge_graph(知识图谱)等信息,如果存在,就直接返回这些最精确的答案。如果不存在,它才会退而求其次,返回前三个常规搜索结果的摘要。这种“智能解析”能为LLM提供质量更高的信息输入。 Tools.py
from serpapi import SerpApiClient
import os
from dotenv import load_dotenv

load_dotenv()

def search(query: str) -> str:
    """
    使用SerpApi搜索网络信息
    它会智能的搜索网络信息,优先返回直接答案,或者知识图谱信息
    """
    print(f"正在使用SerpApi搜索网络信息: {query}")
    try:
        api_key = os.getenv("SERPAPI_API_KEY")
        if not api_key:
            return "错误:未配置SERPAPI_API_KEY环境变量。"
        params = {
            "engine": "google",
            "q": query,
            "api_key": api_key,
            "gl": "cn",  # 国家代码
            "hl": "zh-cn", # 语言代码
        }
        client = SerpApiClient(params)
        results = client.get_dict()

         # 智能解析:优先寻找最直接的答案
        if "answer_box_list" in results:
            return "\n".join(results["answer_box_list"])
        if "answer_box" in results and "answer" in results["answer_box"]:
            return results["answer_box"]["answer"]
        if "knowledge_graph" in results and "description" in results["knowledge_graph"]:
            return results["knowledge_graph"]["description"]
        if "organic_results" in results and results["organic_results"]:
            # 如果没有直接答案,则返回前三个有机结果的摘要
            snippets = [
                f"[{i+1}] {res.get('title', '')}\n{res.get('snippet', '')}"
                for i, res in enumerate(results["organic_results"][:3])
            ]
            return "\n\n".join(snippets)

        return f"对不起,没有找到关于 '{query}' 的信息。"
    except Exception as e:
        print(f"搜索网络信息时发生错误: {e}")
        return f"错误:搜索网络信息时发生错误 - {e}"
因为后续还会有很多的其他工具,所以最好封装一个专门管理当前所有工具的类 ToolExecutor
from typing import Dict, Any

class ToolExecutor:
    """
    一个工具管理器,用于管理和执行工具
    """
    def __init__(self):
        self.tools : Dict[str, Dict[str, Any]] = {}

    def registerTool(self, name: str, description: str, func: callable):
        """
        向工具箱中注册一个新的工具
        """
        if name in self.tools:
            print(f"工具 {name} 已存在,将被覆盖")
        self.tools[name] = { "description" : description, "func" : func }
        print(f"工具 {name} 注册成功")

    def getTool(self, name: str) -> callable:
        """
        根据名称获取工具
        """
        return self.tools.get(name, {}).get("func")

    def getAvailableTools(self) -> str:
        """
        获取所有可用工具的格式化描述字符串
        """
return "\n".join([f"- {name}: {desc}" for name, desc in self.tools.items()])ReActAgent.py
from HelloAgentsLLM import HelloAgentsLLM
from ToolExecutor import ToolExecutor
import re

# ReAct 提示词模板
REACT_PROMPT_TEMPLATE = """
请注意,你是一个有能力调用外部工具的智能助手。

可用工具如下:
{tools}

请严格按照以下格式进行回应:

Thought: 你的思考过程,用于分析问题、拆解任务和规划下一步行动。
Action: 你决定采取的行动,必须是以下格式之一:
- `{{tool_name}}[{{tool_input}}]`:调用一个可用工具。
- `Finish[最终答案]`:当你认为已经获得最终答案时。
- 当你收集到足够的信息,能够回答用户的最终问题时,你必须在Action:字段后使用 Finish[最终答案] 来输出最终答案。

现在,请开始解决以下问题:
Question: {question}
History: {history}
"""

class ReActAgent:
    def __init__(self, llm_client: HelloAgentsLLM, tool_executor: ToolExecutor, max_steps: int = 5):
        self.llm_client = llm_client
        self.tool_executor = tool_executor
        self.max_steps = max_steps
        self.history = []

    def run(self,question:str):
        """
        运行ReAct智能体来回答一个问题
        """
        self.history = [] # 每次运行时重置记录
        current_step = 0 # 当前步骤计数
        while current_step < self.max_steps:
            current_step += 1
            print(f"--- 第 {current_step} 轮思考 ---")

            # 1、格式化提示词
            tools_desc = self.tool_executor.getAvailableTools()
            print(f"可用工具: {tools_desc}")
            history_str = "\n".join(self.history)
            # 构建提示词
            prompt = REACT_PROMPT_TEMPLATE.format(tools = tools_desc,question=question,history=history_str)

            # 2、调用llm回答用户的问题
            messages = [{"role": "user", "content": prompt}]
            response_text = self.llm_client.think(messages=messages)

            # 3、解析LLM的输出
            thought, action = self._parse_output(response_text)

            if thought:
                print(f"思考: {thought}")

            if not action:
                print("警告:未能解析出有效的Action,流程终止。")
                break

            # 4、执行action
            if action.startswith("Finish"):
                tool_name, final_answer = self._parse_action(action)
                if tool_name == "Finish" and final_answer is not None:
                    print(f"最终答案: {final_answer}")
                    return final_answer
                print(f"警告:未能解析 Finish 指令: {action}")
                continue

            tool_name, tool_input = self._parse_action(action)
            if not tool_name or not tool_input:
                print("警告:未能解析出有效的工具名称或输入,流程终止。")
                # TODO 处理无效的Action格式
                continue

            # 5、调用工具
            print(f"行动-调用工具: {tool_name}[{tool_input}]")
            tool_function = self.tool_executor.getTool(tool_name)
            if not tool_function:
                observation = f"错误:未找到工具 {tool_name}"
            else:
                observation = tool_function(tool_input)

            print(f"观察结果: {observation}")

            # 6、记录观察结果
            self.history.append(f"Action: {action}")
            self.history.append(f"Observation: {observation}")

        print("警告:达到最大思考步骤,但未能获得最终答案,流程终止。")
        return None

    # (这些方法是 ReActAgent 类的一部分)
    def _parse_output(self, text: str):
        """解析LLM的输出,提取Thought和Action。
        """
        # Thought: 匹配到 Action: 或文本末尾
        thought_match = re.search(r"Thought:\s*(.*?)(?=\nAction:|$)", text, re.DOTALL)
        # Action: 匹配到文本末尾
        action_match = re.search(r"Action:\s*(.*?)$", text, re.DOTALL)
        thought = thought_match.group(1).strip() if thought_match else None
        action = action_match.group(1).strip() if action_match else None
        return thought, action

    def _parse_action(self, action_text: str):
        """解析Action字符串,提取工具名称和输入。
        """
        match = re.match(r"(\w+)\[(.*)\]", action_text, re.DOTALL)
        if match:
            return match.group(1), match.group(2)
        return None, None
编写测试类
import sys
from pathlib import Path

# 把 ReAct 目录加入模块搜索路径
sys.path.insert(0, str(Path(__file__).resolve().parent.parent))
from Tools import search
from ReActAgent import ReActAgent
from HelloAgentsLLM import HelloAgentsLLM
from ToolExecutor import ToolExecutor

# --- 工具初始化与使用示例 ---
if __name__ == '__main__':

    # 1、初始化执行器
    toolExecutor = ToolExecutor()

    # 2、注册工具
    search_description = "一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。"
    toolExecutor.registerTool("search", search_description, search)

    reactAgent = ReActAgent(llm_client=HelloAgentsLLM(), tool_executor=toolExecutor, max_steps=5)
    question = "小米手机的最新型号是什么,有哪些卖点"
    answer = reactAgent.run(question)
    print(f"最终答案: {answer}")
运行输出效果如下:
工具 search 注册成功
--- 第 1 轮思考 ---
可用工具: - search: {'description': '一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。', 'func': <function search at 0x0000025830129440>}
正在调用 deepseek-chat 模型...
模型响应成功
Thought: 用户询问小米手机的最新型号及其卖点。这是一个关于时事的问题,因为手机型号和卖点会随时间更新,我的知识库可能不包含最新信息。我需要使用搜索工具来获取当前最新的信息。

Action: search[小米手机最新型号 卖点]
思考: 用户询问小米手机的最新型号及其卖点。这是一个关于时事的问题,因为手机型号和卖点会随时间更新,我的知识库可能不包含最新信息。我 需要使用搜索工具来获取当前最新的信息。
行动-调用工具: search[小米手机最新型号 卖点]
正在使用SerpApi搜索网络信息: 小米手机最新型号 卖点
观察结果: [1] 手机 - 小米商城
Xiaomi 17 Max. 4799起 · CPU型号第五代骁龙®8至尊版移动平台 ; Redmi 14C. 599起. CPU型号MediaTek Helio G81-Ultra ; REDMI K90 Pro Max. 3999起 · CPU型号第五代骁龙®8至尊 ...

[2] 2026年618小米红米手机各系列介绍及选购指南( ...
红米K90Max主要卖点是搭载165Hz高刷屏,搭载有散热风扇。是小米首款搭载有散热风扇的机型。 注重轻薄时尚和人像拍照则可以考虑小米Civi5 Pro。 三、红米Note系列和 ...

[3] 小米商城-小米官方网站,小米手机、红米手机正品专卖
搜索商品名称. 首页 分类 米圈 购物车 我的.
--- 第 2 轮思考 ---
可用工具: - search: {'description': '一个网页搜索引擎。当你需要回答关于时事、事实以及在你的知识库中找不到的信息时,应使用此工具。', 'func': <function search at 0x0000025830129440>}
正在调用 deepseek-chat 模型...
模型响应成功
Thought: 根据搜索结果,小米手机的最新型号包括Xiaomi 17 Max、Redmi 14C、REDMI K90 Pro Max等。其中Xiaomi 17 Max的卖点包括第五代骁龙8 至尊版移动平台,REDMI K90 Pro Max的卖点包括第五代骁龙8至尊版移动平台和165Hz高刷屏及散热风扇。我需要整合这些信息来回答用户的问题。

Action: Finish[小米手机的最新型号包括Xiaomi 17 Max、REDMI K90 Pro Max等。主要卖点如下:
- **Xiaomi 17 Max**:起售价4799元,搭载第五代骁龙®8至尊版移动平台。
- **REDMI K90 Pro Max**:起售价3999元,搭载第五代骁龙®8至尊版移动平台,配备165Hz高刷屏,并内置散热风扇,是小米首款搭载散热风扇的机 型。
- **Redmi 14C**:起售价599元,搭载MediaTek Helio G81-Ultra处理器。
此外,注重轻薄时尚和人像拍照的用户可以考虑小米Civi5 Pro。]
思考: 根据搜索结果,小米手机的最新型号包括Xiaomi 17 Max、Redmi 14C、REDMI K90 Pro Max等。其中Xiaomi 17 Max的卖点包括第五代骁龙8至尊版移动平台,REDMI K90 Pro Max的卖点包括第五代骁龙8至尊版移动平台和165Hz高刷屏及散热风扇。我需要整合这些信息来回答用户的问题。
最终答案: 小米手机的最新型号包括Xiaomi 17 Max、REDMI K90 Pro Max等。主要卖点如下:
- **Xiaomi 17 Max**:起售价4799元,搭载第五代骁龙®8至尊版移动平台。
- **REDMI K90 Pro Max**:起售价3999元,搭载第五代骁龙®8至尊版移动平台,配备165Hz高刷屏,并内置散热风扇,是小米首款搭载散热风扇的机 型。
- **Redmi 14C**:起售价599元,搭载MediaTek Helio G81-Ultra处理器。
此外,注重轻薄时尚和人像拍照的用户可以考虑小米Civi5 Pro。
最终答案: 小米手机的最新型号包括Xiaomi 17 Max、REDMI K90 Pro Max等。主要卖点如下:
- **Xiaomi 17 Max**:起售价4799元,搭载第五代骁龙®8至尊版移动平台。
- **REDMI K90 Pro Max**:起售价3999元,搭载第五代骁龙®8至尊版移动平台,配备165Hz高刷屏,并内置散热风扇,是小米首款搭载散热风扇的机 型。
- **Redmi 14C**:起售价599元,搭载MediaTek Helio G81-Ultra处理器。
此外,注重轻薄时尚和人像拍照的用户可以考虑小米Civi5 Pro。当你构建的 ReAct 智能体行为不符合预期时,可以从以下几个方面入手进行调试:
在我们掌握了 ReAct 这种反应式的、步进决策的智能体范式后,接下来将探讨一种风格迥异但同样强大的方法,Plan-and-Solve。顾名思义,这种范式将任务处理明确地分为两个阶段:先规划 (Plan),后执行 (Solve)。
如果说 ReAct 像一个经验丰富的侦探,根据现场的蛛丝马迹(Observation)一步步推理,随时调整自己的调查方向;那么 Plan-and-Solve 则更像一位建筑师,在动工之前必须先绘制出完整的蓝图(Plan),然后严格按照蓝图来施工(Solve)。事实上我们现在用的很多大模型工具的Agent模式都融入了这种设计模式。
Plan-and-Solve Prompting 由 Lei Wang 在2023年提出[2]。其核心动机是为了解决思维链在处理多步骤、复杂问题时容易“偏离轨道”的问题。
与 ReAct 将思考和行动融合在每一步不同,Plan-and-Solve 将整个流程解耦为两个核心阶段,如图4.2所示:
这种“先谋后动”的策略,使得智能体在处理需要长远规划的复杂任务时,能够保持更高的目标一致性,避免在中间步骤中迷失方向。
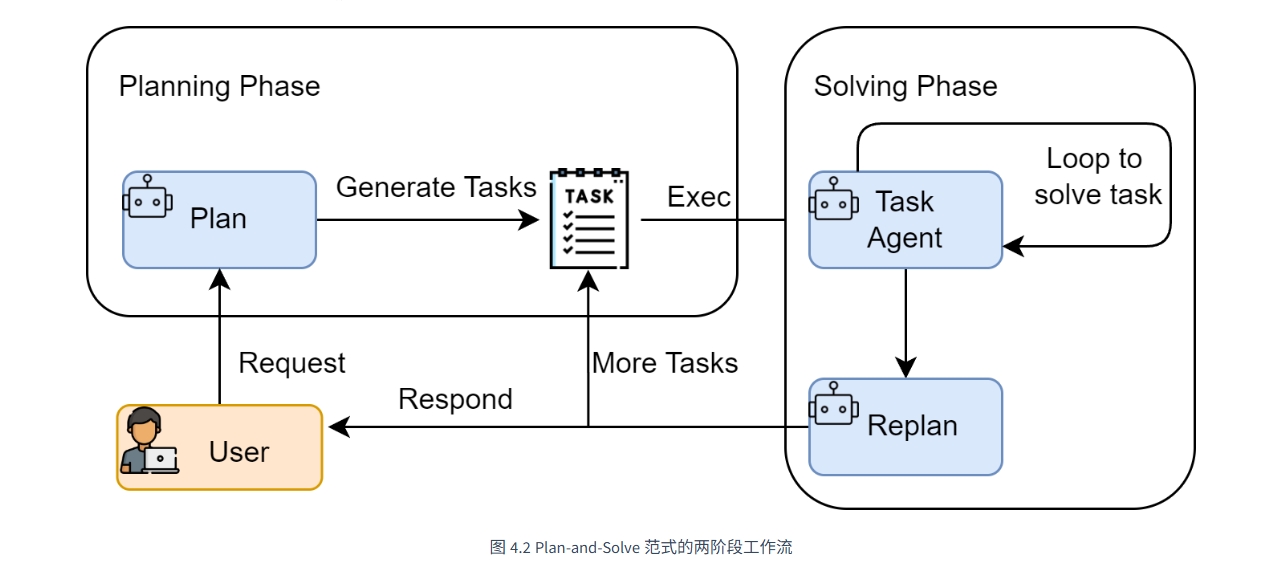
Plan-and-Solve 尤其适用于那些结构性强、可以被清晰分解的复杂任务,例如:
为了凸显 Plan-and-Solve 范式在结构化推理任务上的优势,我们将不使用工具的方式,而是通过提示词的设计,完成一个推理任务。
这类任务的特点是,答案无法通过单次查询或计算得出,必须先将问题分解为一系列逻辑连贯的子步骤,然后按顺序求解。这恰好能发挥 Plan-and-Solve “先规划,后执行”的核心能力。
我们的目标问题是:“一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?”
这个问题对于大语言模型来说并不算特别困难,但它包含了一个清晰的逻辑链条可供参考。在某些实际的逻辑难题上,如果大模型不能高质量的推理出准确的答案,可以参考这个设计模式来设计自己的Agent完成任务。智能体需要:
规划阶段的目标是让大语言模型接收原始问题,并输出一个清晰、分步骤的行动计划。这个计划必须是结构化的,以便我们的代码可以轻松解析并逐一执行。因此,我们设计的提示词需要明确地告诉模型它的角色和任务,并给出一个输出格式的范例。
提示词
PLANNER_PROMPT_TEMPLATE = """
你是一个顶级的AI规划专家。你的任务是将用户提出的复杂问题分解成一个由多个简单步骤组成的行动计划。
请确保计划中的每个步骤都是一个独立的、可执行的子任务,并且严格按照逻辑顺序排列。
你的输出必须是一个Python列表,其中每个元素都是一个描述子任务的字符串。

问题: {question}

请严格按照以下格式输出你的计划,```python与```作为前后缀是必要的:
```python
["步骤1", "步骤2", "步骤3", ...]
``` """
这个提示词通过以下几点确保了输出的质量和稳定性:
接下来,我们将这个提示词逻辑封装成一个 Planner 类,这个类也是我们的规划器。
from HelloAgentsLLM import HelloAgentsLLM
import ast

class Planner:
    def __init__(self, llm_client: HelloAgentsLLM) -> None:
        self.llm_client = llm_client

    def plan(self, question: str) -> list[str]:
        """
        根据用户问题生成一个行动计划表
        """
        prompt = PLANNER_PROMPT_TEMPLATE.format(question=question)
        messages = [{"role": "user", "content": prompt}]

        print("--- 生成行动计划表 ---")
        response_text = self.llm_client.think(messages) or ""

        print(f"行动计划表已生成: {response_text}")

        try:
            # 找到```python和```之间的内容
            plan_str = response_text.split("```python")[1].split("```")[0].strip()
            # 使用ast.literal_eval来安全地执行字符串,将其转换为Python列表
            plan = ast.literal_eval(plan_str)
            return plan if isinstance(plan, list) else []
        except (ValueError, SyntaxError, IndexError) as e:
            print(f"❌ 解析计划时出错: {e}")
            print(f"原始响应: {response_text}")
            return []
        except Exception as e:
            print(f"解析计划表时发生错误: {e}")
return []在规划器 (Planner) 生成了清晰的行动蓝图后,我们就需要一个执行器 (Executor) 来逐一完成计划中的任务。执行器不仅负责调用大语言模型来解决每个子问题,还承担着一个至关重要的角色:状态管理。它必须记录每一步的执行结果,并将其作为上下文提供给后续步骤,确保信息在整个任务链条中顺畅流动
执行器的提示词与规划器不同。它的目标不是分解问题,而是在已有上下文的基础上,专注解决当前这一个步骤。因此,提示词需要包含以下关键信息:
from HelloAgentsLLM import HelloAgentsLLM
EXECUTOR_PROMPT_TEMPLATE = """
你是一位顶级的AI执行专家。你的任务是严格按照给定的计划,一步步地解决问题。
你将收到原始问题、完整的计划、以及到目前为止已经完成的步骤和结果。
请你专注于解决“当前步骤”,并仅输出该步骤的最终答案,不要输出任何额外的解释或对话。

# 原始问题:
{question}

# 完整计划:
{plan}

# 历史步骤与结果:
{history}

# 当前步骤:
{current_step}

请仅输出针对“当前步骤”的回答:
"""

class Executor:
    def __init__(self, llm_client: HelloAgentsLLM) -> None:
        self.llm_client = llm_client

    def execute(self, question: str, plan: list[str]) -> str:
        """
        严格按照计划解决当前步骤,并返回最终答案
        """
        history = "" # 用于存储历史步骤结果的字符串

        print("--- 开始执行计划 ---")
        for i, step in enumerate(plan):
            print(f"--- 执行步骤 {i+1}/{len(plan)}: {step} ---")
            prompt = EXECUTOR_PROMPT_TEMPLATE.format(
                question=question,
                plan=plan,
                history=history,
                current_step=step
            )
            messages = [{"role": "user", "content": prompt}]
            response_text = self.llm_client.think(messages) or ""

            # 更新历史记录
            history += f"\n步骤 {i+1}: {step}\n结果: {response_text}"

            print(f"步骤 {i+1} 已完成,结果: {response_text}")

        print("--- 计划执行完成 ---")
        final_answer = response_text
return final_answerfrom Planner import Planner
from Executor import Executor
from HelloAgentsLLM import HelloAgentsLLM
class PlanAndSolveAgent:
def __init__(self, llm_client: HelloAgentsLLM) -> None:
"""
初始化智能体,同时创建规划器和执行器
"""
self.llm_client = llm_client
self.planner = Planner(llm_client)
self.executor = Executor(llm_client)
def run(self, question: str):
"""
运行智能体完整流程:1、先规划 后执行
"""
print(f"\n--- 开始处理问题 ---\n问题: {question}")
plan = self.planner.plan(question)
if not plan:
print("❌ 未能生成有效的行动计划")
return None
final_answer = self.executor.execute(question, plan)
if not final_answer:
print("❌ 未能获得最终答案")
return None
print(f"\n--- 最终答案 ---\n{final_answer}")
return final_answerfrom HelloAgentsLLM import HelloAgentsLLM
from PlanAndSolveAgent import PlanAndSolveAgent
if __name__ == "__main__":
llm_client = HelloAgentsLLM()
agent = PlanAndSolveAgent(llm_client)
question = "一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?"
final_answer = agent.run(question)
print(f"最终答案: {final_answer}")--- 开始处理问题 ---
问题: 一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?
--- 生成行动计划表 ---
正在调用 deepseek-chat 模型...
模型响应成功
```python
["计算周二卖出的苹果数量:15乘以2", "计算周三卖出的苹果数量:周二的数量减去5", "计算三天总销量:周一的数量加上周二的数量再加上周三的数量"]行动计划表已生成: ```python ["计算周二卖出的苹果数量:15乘以2", "计算周三卖出的苹果数量:周二的数量减去5", "计算三天总销量:周一的数量加上周二的数量再加上周三的数量"]
--- 开始执行计划 ---
--- 执行步骤 1/3: 计算周二卖出的苹果数量:15乘以2 ---
正在调用 deepseek-chat 模型...
模型响应成功
30
步骤 1 已完成,结果: 30
--- 执行步骤 2/3: 计算周三卖出的苹果数量:周二的数量减去5 ---
正在调用 deepseek-chat 模型...
模型响应成功
30减去5等于25
步骤 2 已完成,结果: 30减去5等于25
--- 执行步骤 3/3: 计算三天总销量:周一的数量加上周二的数量再加上周三的数量 ---
正在调用 deepseek-chat 模型...
模型响应成功
15加上30再加上25等于70
步骤 3 已完成,结果: 15加上30再加上25等于70
--- 计划执行完成 ---

--- 最终答案 ---
15加上30再加上25等于70
最终答案: 15加上30再加上25等于70在我们已经实现的 ReAct 和 Plan-and-Solve 范式中,智能体一旦完成了任务,其工作流程便告结束。然而,它们生成的初始答案,无论是行动轨迹还是最终结果,都可能存在谬误或有待改进之处。Reflection 机制的核心思想,正是为智能体引入一种事后(post-hoc)的自我校正循环,使其能够像人类一样,审视自己的工作,发现不足,并进行迭代优化。
Reflection 机制的灵感来源于人类的学习过程:我们完成初稿后会进行校对,解出数学题后会进行验算。这一思想在多个研究中得到了体现,例如 Shinn, Noah 在2023年提出的 Reflexion 框架[3]。其核心工作流程可以概括为一个简洁的三步循环:执行 -> 反思 -> 优化。
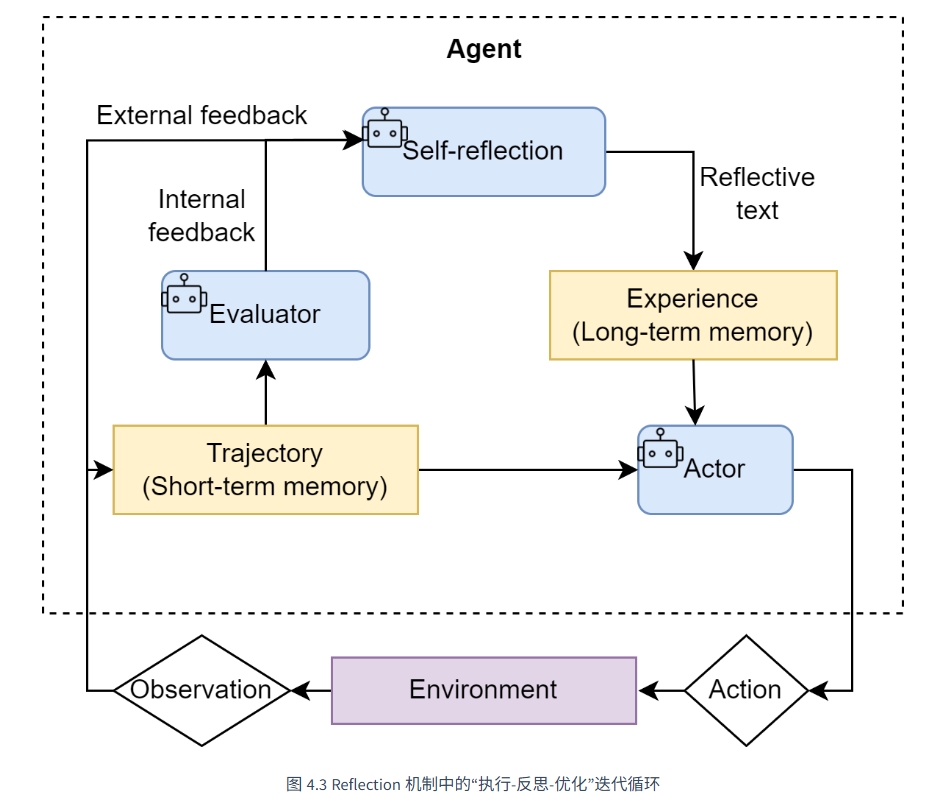
与前两种范式相比,Reflection 的价值在于:
为了在实战中体现 Reflection 机制,我们将引入记忆管理机制,因为reflection通常对应着信息的存储和提取,如果上下文足够长的情况,想让“评审员”直接获取所有的信息然后进行反思往往会传入很多冗余信息。这一步实践我们主要完成代码生成与迭代优化。
这一步的目标任务是:“编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。”
这个任务是检验 Reflection 机制的绝佳场景:
存在明确的优化路径:大语言模型初次生成的代码很可能是一个简单但效率低下的递归实现。 反思点清晰:可以通过反思发现其“时间复杂度过高”或“存在重复计算”的问题。 优化方向明确:可以根据反馈,将其优化为更高效的迭代版本或使用备忘录模式的版本。 Reflection 的核心在于迭代,而迭代的前提是能够记住之前的尝试和获得的反馈。因此,一个“短期记忆”模块是实现该范式的必需品。这个记忆模块将负责存储每一次“执行-反思”循环的完整轨迹。
Memory.py
from typing import List, Dict, Any, Optional

class Memory:
    """
    一个简单的短期记忆模块,用于存储智能体的行动与反思轨迹。
    """

    def __init__(self):
        """
        初始化一个空列表来存储所有记录。
        """
        self.records: List[Dict[str, Any]] = []

    def add_record(self, record_type: str, content: str):
        """
        向记忆中添加一条新记录。

        参数:
        - record_type (str): 记录的类型 ('execution' 或 'reflection')。
        - content (str): 记录的具体内容 (例如,生成的代码或反思的反馈)。
        """
        record = {"type": record_type, "content": content}
        self.records.append(record)
        print(f"📝 记忆已更新,新增一条 '{record_type}' 记录。")

    def get_trajectory(self) -> str:
        """
        将所有记忆记录格式化为一个连贯的字符串文本,用于构建提示词。
        """
        trajectory_parts = []
        for record in self.records:
            if record['type'] == 'execution':
                trajectory_parts.append(f"--- 上一轮尝试 (代码) ---\n{record['content']}")
            elif record['type'] == 'reflection':
                trajectory_parts.append(f"--- 评审员反馈 ---\n{record['content']}")

        return "\n\n".join(trajectory_parts)

    def get_last_execution(self) -> Optional[str]:
        """
        获取最近一次的执行结果 (例如,最新生成的代码)。
        如果不存在,则返回 None。
        """
        for record in reversed(self.records):
            if record['type'] == 'execution':
                return record['content']
        return None
有了 Memory 模块作为基础,我们现在可以着手构建 ReflectionAgent 的核心逻辑。整个智能体的工作流程将围绕我们之前讨论的“执行-反思-优化”循环展开,并通过精心设计的提示词来引导大语言模型扮演不同的角色。
(1)提示词设计
与之前的范式不同,Reflection 机制需要多个不同角色的提示词来协同工作。
初始执行提示词 (Execution Prompt) :这是智能体首次尝试解决问题的提示词,内容相对直接,只要求模型完成指定任务。
INITIAL_PROMPT_TEMPLATE = """
你是一位资深的Python程序员。请根据以下要求,编写一个Python函数。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。

要求: {task}

请直接输出代码,不要包含任何额外的解释。
"""
(2)反思提示词 (Reflection Prompt) :这个提示词是 Reflection 机制的灵魂。它指示模型扮演“代码评审员”的角色,对上一轮生成的代码进行批判性分析,并提供具体的、可操作的反馈。
REFLECT_PROMPT_TEMPLATE = """
你是一位极其严格的代码评审专家和资深算法工程师,对代码的性能有极致的要求。
你的任务是审查以下Python代码,并专注于找出其在<strong>算法效率</strong>上的主要瓶颈。

# 原始任务:
{task}

# 待审查的代码:
```python
{code}请分析该代码的时间复杂度,并思考是否存在一种算法上更优的解决方案来显著提升性能。 如果存在,请清晰地指出当前算法的不足,并提出具体的、可行的改进算法建议(例如,使用筛法替代试除法)。 如果代码在算法层面已经达到最优,才能回答“无需改进”。
请直接输出你的反馈,不要包含任何额外的解释。 """
(3)优化提示词 (Refinement Prompt) :当收到反馈后,这个提示词将引导模型根据反馈内容,对原有代码进行修正和优化。

```py
REFINE_PROMPT_TEMPLATE = """
你是一位资深的Python程序员。你正在根据一位代码评审专家的反馈来优化你的代码。

# 原始任务:
{task}

# 你上一轮尝试的代码:
{last_code_attempt}
评审员的反馈:
{feedback}

请根据评审员的反馈,生成一个优化后的新版本代码。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。
请直接输出优化后的代码,不要包含任何额外的解释。
"""
ReflectionAgent.py
# 假设 llm_client.py 和 memory.py 已定义
from Memory import Memory

class ReflectionAgent:
    def __init__(self, llm_client, max_iterations=3):
        self.llm_client = llm_client
        self.memory = Memory()
        self.max_iterations = max_iterations

    def run(self, task: str):
        print(f"\n--- 开始处理任务 ---\n任务: {task}")

        # --- 1. 初始执行 ---
        print("\n--- 正在进行初始尝试 ---")
        initial_prompt = INITIAL_PROMPT_TEMPLATE.format(task=task)
        initial_code = self._get_llm_response(initial_prompt)
        self.memory.add_record("execution", initial_code)

        # --- 2. 迭代循环:反思与优化 ---
        for i in range(self.max_iterations):
            print(f"\n--- 第 {i+1}/{self.max_iterations} 轮迭代 ---")

            # a. 反思
            print("\n-> 正在进行反思...")
            last_code = self.memory.get_last_execution()
            reflect_prompt = REFLECT_PROMPT_TEMPLATE.format(task=task, code=last_code)
            feedback = self._get_llm_response(reflect_prompt)
            self.memory.add_record("reflection", feedback)

            # b. 检查是否需要停止
            if "无需改进" in feedback:
                print("\n✅ 反思认为代码已无需改进,任务完成。")
                break

            # c. 优化
            print("\n-> 正在进行优化...")
            refine_prompt = REFINE_PROMPT_TEMPLATE.format(
                task=task,
                last_code_attempt=last_code,
                feedback=feedback
            )
            refined_code = self._get_llm_response(refine_prompt)
            self.memory.add_record("execution", refined_code)

        final_code = self.memory.get_last_execution()
        print(f"\n--- 任务完成 ---\n最终生成的代码:\n```python\n{final_code}\n```")
        return final_code

    def _get_llm_response(self, prompt: str) -> str:
        """一个辅助方法,用于调用LLM并获取完整的流式响应。"""
        messages = [{"role": "user", "content": prompt}]
        response_text = self.llm_client.think(messages=messages) or ""
        return response_text
测试案例
import sys
from pathlib import Path
# 把 ReAct 目录加入模块搜索路径
sys.path.insert(0, str(Path(__file__).resolve().parent.parent))

from HelloAgentsLLM import HelloAgentsLLM
from ReflectionAgent import ReflectionAgent

if __name__ == '__main__':
    llm_client = HelloAgentsLLM()
    reflection_agent = ReflectionAgent(llm_client)
    question = "找出1到n之间所有的素数 (prime numbers)。"
    final_answer = reflection_agent.run(question)
    print(f"最终答案: {final_answer}")
--- 开始处理任务 --- 任务: 找出1到n之间所有的素数 (prime numbers)。
--- 正在进行初始尝试 --- 正在调用 deepseek-chat 模型... 模型响应成功
def find_primes_up_to_n(n: int) -> list[int]:
    """
    Find all prime numbers between 1 and n (inclusive).

    Uses the Sieve of Eratosthenes algorithm for efficient computation.

    Args:
        n: A positive integer representing the upper bound (inclusive).

    Returns:
        A list of all prime numbers from 1 to n, sorted in ascending order.

    Raises:
        ValueError: If n is less than 1.

    Examples:
        >>> find_primes_up_to_n(10)
        [2, 3, 5, 7]
        >>> find_primes_up_to_n(1)
        []
        >>> find_primes_up_to_n(20)
        [2, 3, 5, 7, 11, 13, 17, 19]
    """
    if n < 1:
        raise ValueError("n must be a positive integer")

    if n < 2:
        return []

    # Sieve of Eratosthenes
    is_prime = [True] * (n + 1)
    is_prime[0] = is_prime[1] = False

    for i in range(2, int(n ** 0.5) + 1):
        if is_prime[i]:
            # Mark multiples of i as non-prime
            for j in range(i * i, n + 1, i):
                is_prime[j] = False

    return [num for num, prime in enumerate(is_prime) if prime]
📝 记忆已更新,新增一条 'execution' 记录。
--- 第 1/3 轮迭代 ---
-> 正在进行反思... 正在调用 deepseek-chat 模型... 模型响应成功 该代码已经使用了埃拉托色尼筛法,时间复杂度为 O(n log log n),空间复杂度为 O(n),在通用场景下是求解 1 到 n 之间所有素数的最优算法之一,无需改进。 📝 记忆已更新,新增一条 'reflection' 记录。
✅ 反思认为代码已无需改进,任务完成。
--- 任务完成 --- 最终生成的代码:
```python
def find_primes_up_to_n(n: int) -> list[int]:
    """
    Find all prime numbers between 1 and n (inclusive).

    Uses the Sieve of Eratosthenes algorithm for efficient computation.

    Args:
        n: A positive integer representing the upper bound (inclusive).

    Returns:
        A list of all prime numbers from 1 to n, sorted in ascending order.

    Raises:
        ValueError: If n is less than 1.

    Examples:
        >>> find_primes_up_to_n(10)
        [2, 3, 5, 7]
        >>> find_primes_up_to_n(1)
        []
        >>> find_primes_up_to_n(20)
        [2, 3, 5, 7, 11, 13, 17, 19]
    """
    if n < 1:
        raise ValueError("n must be a positive integer")

    if n < 2:
        return []

    # Sieve of Eratosthenes
    is_prime = [True] * (n + 1)
    is_prime[0] = is_prime[1] = False

    for i in range(2, int(n ** 0.5) + 1):
        if is_prime[i]:
            # Mark multiples of i as non-prime
            for j in range(i * i, n + 1, i):
                is_prime[j] = False

    return [num for num, prime in enumerate(is_prime) if prime]
最终答案: ```python
def find_primes_up_to_n(n: int) -> list[int]:
"""
Find all prime numbers between 1 and n (inclusive).
Uses the Sieve of Eratosthenes algorithm for efficient computation.
Args:
n: A positive integer representing the upper bound (inclusive).
Returns:
A list of all prime numbers from 1 to n, sorted in ascending order.
Raises:
ValueError: If n is less than 1.
Examples:
>>> find_primes_up_to_n(10)
[2, 3, 5, 7]
>>> find_primes_up_to_n(1)
[]
>>> find_primes_up_to_n(20)
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
[2, 3, 5, 7]
>>> find_primes_up_to_n(1)
[]
>>> find_primes_up_to_n(20)
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
raise ValueError("n must be a positive integer")
[2, 3, 5, 7]
>>> find_primes_up_to_n(1)
[]
>>> find_primes_up_to_n(20)
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
raise ValueError("n must be a positive integer")
[2, 3, 5, 7]
>>> find_primes_up_to_n(1)
[]
>>> find_primes_up_to_n(20)
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
>>> find_primes_up_to_n(1)
[]
>>> find_primes_up_to_n(20)
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
>>> find_primes_up_to_n(20)
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
[2, 3, 5, 7, 11, 13, 17, 19]
"""
if n < 1:
raise ValueError("n must be a positive integer")
if n < 1:
raise ValueError("n must be a positive integer")
raise ValueError("n must be a positive integer")
if n < 2:
return []
# Sieve of Eratosthenes
is_prime = [True] * (n + 1)
is_prime[0] = is_prime[1] = False
for i in range(2, int(n ** 0.5) + 1):
if is_prime[i]:
# Mark multiples of i as non-prime
for j in range(i * i, n + 1, i):
is_prime[j] = False
return [num for num, prime in enumerate(is_prime) if prime]这个运行实例展示了 Reflection 机制是如何驱动智能体进行深度优化的:
有效的“批判”是优化的前提:在第一轮反思中,由于我们使用了“极其严格”且“专注于算法效率”的提示词,智能体没有满足于功能正确的初版代码,而是精准地指出了其 O(n * sqrt(n)) 的时间复杂度瓶颈,并提出了算法层面的改进建议——埃拉托斯特尼筛法。 迭代式改进: 智能体在接收到明确的反馈后,于优化阶段成功地实现了更高效的筛法,将算法复杂度降至 O(n log log n),完成了第一次有意义的自我迭代。 收敛与终止: 在第二轮反思中,智能体面对已经高效的筛法,展现出了更深层次的知识。它不仅肯定了当前算法的效率,甚至还提及了分段筛法等更高级的优化方向,但最终做出了“在一般情况下无需改进”的正确判断。这个判断触发了我们的终止条件,使优化过程得以收敛。 这个案例充分证明,一个设计良好的 Reflection 机制,其价值不仅在于修复错误,更在于驱动解决方案在质量和效率上实现阶梯式的提升,这使其成为构建复杂、高质量智能体的关键技术之一。
尽管 Reflection 机制在提升任务解决质量上表现出色,但这种能力的获得并非没有代价。在实际应用中,我们需要权衡其带来的收益与相应的成本。
(1)主要成本
模型调用开销增加:这是最直接的成本。每进行一轮迭代,至少需要额外调用两次大语言模型(一次用于反思,一次用于优化)。如果迭代多轮,API 调用成本和计算资源消耗将成倍增加。
任务延迟显著提高:Reflection 是一个串行过程,每一轮的优化都必须等待上一轮的反思完成。这使得任务的总耗时显著延长,不适合对实时性要求高的场景。
提示工程复杂度上升:如我们的案例所示,Reflection 的成功在很大程度上依赖于高质量、有针对性的提示词。为“执行”、“反思”、“优化”等不同阶段设计和调试有效的提示词,需要投入更多的开发精力。
(2)核心收益
解决方案质量的跃迁:最大的收益在于,它能将一个“合格”的初始方案,迭代优化成一个“优秀”的最终方案。这种从功能正确到性能高效、从逻辑粗糙到逻辑严谨的提升,在很多关键任务中是至关重要的。
鲁棒性与可靠性增强:通过内部的自我纠错循环,智能体能够发现并修复初始方案中可能存在的逻辑漏洞、事实性错误或边界情况处理不当等问题,从而大大提高了最终结果的可靠性。
综上所述,Reflection 机制是一种典型的“以成本换质量”的策略。它非常适合那些对最终结果的质量、准确性和可靠性有极高要求,且对任务完成的实时性要求相对宽松的场景。例如:
生成关键的业务代码或技术报告。 在科学研究中进行复杂的逻辑推演。 需要深度分析和规划的决策支持系统。 反之,如果应用场景需要快速响应,或者一个“大致正确”的答案就已经足够,那么使用更轻量的 ReAct 或 Plan-and-Solve 范式可能会是更具性价比的选择。
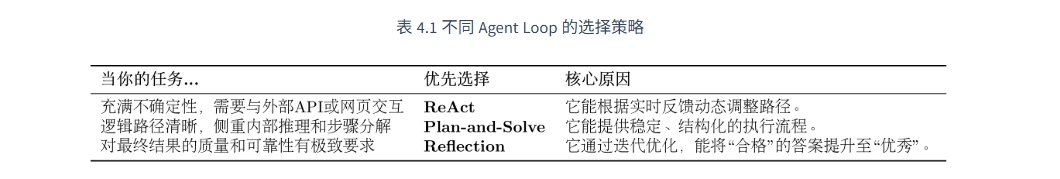
ReAct:我们构建了一个能与外部世界交互的 ReAct 智能体。通过“思考-行动-观察”的动态循环,它成功地利用搜索引擎回答了自身知识库无法覆盖的实时性问题。其核心优势在于环境适应性和动态纠错能力,使其成为处理探索性、需要外部工具输入的任务的首选。
Plan-and-Solve:我们实现了一个先规划后执行的 Plan-and-Solve 智能体,并利用它解决了需要多步推理的数学应用题。它将复杂的任务分解为清晰的步骤,然后逐一执行。其核心优势在于结构性和稳定性,特别适合处理逻辑路径确定、内部推理密集的任务。
Reflection (自我反思与迭代):我们构建了一个具备自我优化能力的 Reflection 智能体。通过引入“执行-反思-优化”的迭代循环,它成功地将一个效率较低的初始代码方案,优化为了一个算法上更优的高性能版本。其核心价值在于能显著提升解决方案的质量,适用于对结果的准确性和可靠性有极高要求的场景。
AutoGen 运行总流程:
先定义多个智能体 → 组建群聊 → 用户发需求 → Agent 自动聊天协作 → 执行代码 / 工具 → 完成任务并停止
autogen-core:底层基座,封装LLM请求、消息结构体、基础通信、异步调度;autogen-agentchat:上层应用层,提供对话智能体、群聊、团队管理高阶API,基于core封装,解耦底层与业务开发。async/await,解决LLM接口IO阻塞问题,提升多Agent并发执行效率,是0.7.4版本架构革新重点。| 组件 | 功能定位 | 关键能力 |
|---|---|---|
| AssistantAgent | 思考决策者(专家角色) | 绑定LLM,通过System Prompt定制产品/开发/测试等角色,输出方案、代码、评审意见 |
| UserProxyAgent | 人类代理+代码执行器 | 1. 接收用户原始需求;2. 沙箱执行Python代码;3. 捕获运行结果/报错,回传给助理智能体迭代优化 |
| RoundRobinGroupChat | 群聊调度器 | 固定顺序轮询发言(产品→开发→测试),管控对话启停,替代旧版GroupChatManager |
当任务需要多个智能体协作时,就需要一个机制来协调对话流程。在早期版本中,GroupChatManager 承担了这一职责。而在新架构中,引入了更灵活的 Team 或群聊概念,例如 RoundRobinGroupChat。
_ 轮询群聊 (RoundRobinGroupChat): 这是一种明确的、顺序化的对话协调机制。它会让参与的智能体按照预定义的顺序依次发言。这种模式非常适用于流程固定的任务,例如一个典型的软件开发流程:产品经理先提出需求,然后工程师编写代码,最后由代码审查员进行检查。 _ 工作流: 1、首先,创建一个 RoundRobinGroupChat 实例,并将所有参与协作的智能体(如产品经理、工程师等)加入其中。 2、当一个任务开始时,群聊会按照预设的顺序,依次激活相应的智能体。 3、被选中的智能体根据当前的对话上下文进行响应。 4、群聊将新的回复加入对话历史,并激活下一个智能体。 5、这个过程会持续进行,直到达到最大对话轮次或满足预设的终止条件。
通过这种方式,AutoGen 将复杂的协作关系,简化为一个流程清晰、易于管理的自动化“圆桌会议”。开发者只需定义好每个团队成员的角色和发言顺序,剩下的协作流程便可由群聊机制自主驱动。
用户输入需求 → 产品输出PRD → 工程师编码 → 测试跑用例报错 → 开发迭代修复 → 最终可用项目交付,全程仅需开发者初始化角色配置,剩余协作全由Agent自主对话完成。
安装可能网络超时,所以可以采用国内镜像
pip install -U "autogen-agentchat" "autogen-ext[openai]"AutoGenAgent.py
from autogen_ext.models.openai import OpenAIChatCompletionClient
from autogen_agentchat.agents import AssistantAgent, UserProxyAgent
from autogen_agentchat.teams import RoundRobinGroupChat
from autogen_agentchat.conditions import TextMentionTermination
import os
from dotenv import load_dotenv

# 加载环境变量
load_dotenv()

def create_openai_model_client():
    """创建并配置 OpenAI 模型客户端"""
    return OpenAIChatCompletionClient(
        model=os.getenv("LLM_MODEL_ID"),
        api_key=os.getenv("LLM_API_KEY"),
        base_url=os.getenv("LLM_BASE_URL"),
        model_info={
            "function_calling": True,
            "max_tokens": 4096,
            "context_length": 32768,
            "vision": False,
            "json_output": True,
            "family": "deepseek",
            "structured_output": True,
        }
    )

def create_product_manager(model_client):
    """创建产品经理智能体"""
    system_message = """你是一位经验丰富的产品经理,专门负责软件产品的需求分析和项目规划。

你的核心职责包括:
1. **需求分析**:深入理解用户需求,识别核心功能和边界条件
2. **技术规划**:基于需求制定清晰的技术实现路径
3. **风险评估**:识别潜在的技术风险和用户体验问题
4. **协调沟通**:与工程师和其他团队成员进行有效沟通

当接到开发任务时,请按以下结构进行分析:
1. 需求理解与分析
2. 功能模块划分
3. 技术选型建议
4. 实现优先级排序
5. 验收标准定义

请简洁明了地回应,并在分析完成后说"请工程师开始实现"。"""

    return AssistantAgent(
        name="ProductManager",
        model_client=model_client,
        system_message=system_message,
    )


def create_engineer(model_client):
    """创建工程师智能体"""
    system_message = """你是一位资深的软件工程师,擅长 Python 开发和 Web 应用构建。

    你的技术专长包括:
    1. **Python 编程**:熟练掌握 Python 语法和最佳实践
    2. **Web 开发**:精通 Streamlit、Flask、Django 等框架
    3. **API 集成**:有丰富的第三方 API 集成经验
    4. **错误处理**:注重代码的健壮性和异常处理

    当收到开发任务时,请:
    1. 仔细分析技术需求
    2. 选择合适的技术方案
    3. 编写完整的代码实现
    4. 添加必要的注释和说明
    5. 考虑边界情况和异常处理

    请提供完整的可运行代码,并在完成后说"请代码审查员检查"。"""

    return AssistantAgent(
        name="Engineer",
        model_client=model_client,
        system_message=system_message,
    )


def create_code_reviewer(model_client):
    """创建代码审查员智能体"""
    system_message = """你是一位经验丰富的代码审查专家,专注于代码质量和最佳实践。

你的审查重点包括:
1. **代码质量**:检查代码的可读性、可维护性和性能
2. **安全性**:识别潜在的安全漏洞和风险点
3. **最佳实践**:确保代码遵循行业标准和最佳实践
4. **错误处理**:验证异常处理的完整性和合理性

审查流程:
1. 仔细阅读和理解代码逻辑
2. 检查代码规范和最佳实践
3. 识别潜在问题和改进点
4. 提供具体的修改建议
5. 评估代码的整体质量

请提供具体的审查意见,完成后说"代码审查完成,请用户代理测试"。"""

    return AssistantAgent(
        name="CodeReviewer",
        model_client=model_client,
        system_message=system_message,
    )


def create_user_proxy():
    """创建用户代理智能体"""
    return UserProxyAgent(
        name="UserProxy",
        description="""用户代理,负责以下职责:
1. 代表用户提出开发需求
2. 执行最终的代码实现
3. 验证功能是否符合预期
4. 提供用户反馈和建议

完成测试后请回复 TERMINATE。""",
    )


# 1. 创建 LLM 客户端(AI 角色共用)
model_client = create_openai_model_client()
# 2. 创建各个 agent 角色
product_manager = create_product_manager(model_client)
engineer = create_engineer(model_client)
code_reviewer = create_code_reviewer(model_client)
user_proxy = create_user_proxy()  # 不需要 model_client

# 定义团队聊天和协作规则
team_chat = RoundRobinGroupChat(
    participants=[
        product_manager,
        engineer,
        code_reviewer,
        user_proxy,
    ],
    termination_condition=TextMentionTermination("TERMINATE"),
    max_turns=20,
)
UnitTest.py
import asyncio

from autogen_agentchat.ui import Console

from AutoGenAgent import team_chat


async def run_software_development_team():
    # 定义任务描述
    task = """我们需要开发一个比特币价格显示应用,具体要求如下:
            核心功能:
            - 实时显示比特币当前价格(USD)
            - 显示24小时价格变化趋势(涨跌幅和涨跌额)
            - 提供价格刷新功能

            技术要求:
            - 使用 Streamlit 框架创建 Web 应用
            - 界面简洁美观,用户友好
            - 添加适当的错误处理和加载状态

            请团队协作完成这个任务,从需求分析到最终实现。"""

    # 异步执行团队协作,并流式输出对话过程
    result = await Console(team_chat.run_stream(task=task))
    return result


if __name__ == "__main__":
    result = asyncio.run(run_software_development_team())
运行效果
🔧 正在初始化模型客户端...
👥 正在创建智能体团队...
🚀 启动 AutoGen 软件开发团队协作...
============================================================
---------- TextMessage (user) ----------
我们需要开发一个比特币价格显示应用,具体要求如下:
...
请团队协作完成这个任务,从需求分析到最终实现。
---------- TextMessage (ProductManager) ----------
### 1. 需求理解与分析
...
请工程师开始实现。
---------- TextMessage (Engineer) ----------
### 技术方案实施
...
请代码审查员检查。
---------- TextMessage (CodeReviewer) ----------
### 代码审查
...
代码审查完成,请用户代理测试。
---------- TextMessage (UserProxy) ----------
已经完成需求
---------- TextMessage (ProductManager) ----------
太好了,感谢您的反馈!如果在使用过程中有任何问题,或者有其他功能需求和改进建议,请随时告知我们。我们会持续提供支持和改进。期待您对我们的应用
有愉快的使用体验!
---------- TextMessage (Engineer) ----------
很高兴听到项目顺利完成。如果您或用户有任何问题或者需要帮助,请随时联系我们。感谢您对我们工作的支持,让我们一起确保应用稳定运行并不断优化用户
体验!
---------- TextMessage (CodeReviewer) ----------
非常感谢大家的努力与协作,使得项目能够顺利完成。未来若有更多技术支持的需求或者需要改进的地方,我们愿意为项目的持续优化贡
献力量。期待用户能够享受到流畅的体验,同时也欢迎提出更多的反馈与建议。再次感谢团队的合作!
---------- TextMessage (UserProxy) ----------
Enter your response: TERMINATE
============================================================
✅ 团队协作完成!

📋 协作结果摘要:
- 参与智能体数量:4个
- 任务完成状态:成功
CAMEL 实现自主协作的基石是两大核心概念:角色扮演 (Role-Playing) 和 引导性提示 (Inception Prompting)。
(1)角色扮演
在 CAMEL 最初的设计中,一个任务通常由两个智能体协作完成。这两个智能体被赋予了互补的、明确定义的“角色”。一个扮演“AI 用户” (AI User),负责提出需求、下达指令和构思任务步骤;另一个则扮演“AI 助理” (AI Assistant),负责根据指令执行具体操作和提供解决方案。
例如,在一个“开发股票交易策略分析工具”的任务中:
AI 用户 的角色可能是一位“资深股票交易员”。它懂市场、懂策略,但不懂编程。 AI 助理 的角色则是一位“优秀的 Python 程序员”。它精通编程,但对股票交易一无所知。 通过这种设定,任务的解决过程就被自然地转化为一场两位“跨领域专家”之间的对话。交易员提出专业需求,程序员将其转化为代码实现,两者协作完成任何一方都无法独立完成的复杂任务。
(2)引导性提示
仅仅设定角色还不够,如何确保两个 AI 在没有人类持续监督的情况下,能始终“待在自己的角色里”,并且高效地朝着共同目标前进呢?这就是 CAMEL 最核心的技术,引导性提示发挥作用的地方。“引导性提示”是在对话开始前,分别注入给两个智能体的一段精心设计的、结构化的初始指令(System Prompt)。这段指令就像是为智能体植入的“行动纲领”,它通常包含以下几个关键部分:
明确自身角色:例如,“你是一位资深的股票交易员...” 告知协作者角色:例如,“你正在与一位优秀的 Python 程序员合作...” 定义共同目标:例如,“你们的共同目标是开发一个股票交易策略分析工具。” 设定行为约束和沟通协议:这是最关键的一环。例如,指令会要求 AI 用户“一次只提出一个清晰、具体的步骤”,并要求 AI 助理“在完成上一步之前不要追问更多细节”,同时规定双方需在回复的末尾使用特定标志(如 <SOLUTION>)来标识任务的完成。
CAMEL主打双智能体角色扮演+引导提示自主协作,轻量化设计,不靠硬编码流程,依托提示词约束对话,用最少人工干预完成开放式创作类任务,核心起源是NeurIPS2023论文,主打双人跨专家协作。
设计思想:重提示、轻架构,区别AutoGen多角色群聊、AgentScope消息总线、LangGraph显式流程图编程。
固定成对互补角色,AI User(需求方)+ AI Assistant(落地执行方),分工永久固定:
案例:写书场景→User=心理学专家,Assistant=图书撰稿人;开发场景→User=金融分析师,Assistant=Python开发。
启动前一次性给两个Agent下发结构化全局协议,内容包含:
<CAMEL_TASK_DONE>,对话出现该标识自动结束任务。 靠初始提示约束全流程,不用开发者手动写流转逻辑,AI自主交替对话推进任务。1. 定义双角色名称+全局任务 → 2. 注入Inception初始化提示协议
→3. 双方交替轮询对话迭代产出 →4. 出现<CAMEL_TASK_DONE>自动停止,汇总成品init_chat(),双方一问一答分步落地;<CAMEL_TASK_DONE>,结束协作,整合全部对话内容为最终成果。准备工作
pip install camel-ai coloramafrom colorama import Fore
from camel.societies import RolePlaying
from camel.utils import print_text_animated
from camel.models import ModelFactory
from camel.types import ModelPlatformType
import os
from dotenv import load_dotenv
# 加载环境变量
load_dotenv()
LLM_API_KEY = os.getenv("LLM_API_KEY")
LLM_BASE_URL = os.getenv("LLM_BASE_URL")
LLM_MODEL_ID = os.getenv("LLM_MODEL_ID")
#创建模型,在这里以deepseek为例,调用的百炼大模型平台API
model = ModelFactory.create(
model_platform=ModelPlatformType.DEEPSEEK,
model_type=LLM_MODEL_ID,
url=LLM_BASE_URL,
api_key=LLM_API_KEY
)
# 1、定义协作任务
task_prompt = """
创作一本关于"拖延症心理学"的短篇电子书,目标读者是对心理学感兴趣的普通大众。
要求:
1. 内容科学严谨,基于实证研究
2. 语言通俗易懂,避免过多专业术语
3. 包含实用的改善建议和案例分析
4. 篇幅控制在1000-5000字
5. 结构清晰,包含引言、核心章节和总结
"""
print(Fore.YELLOW + f"协作任务:\n{task_prompt}\n")
# 2、初始化角色扮演会话实例
# 它根据我们提供的角色和任务,快速构建一个双智能体协作“社会”。
# AI 作家作为 "user",负责提出写作结构和要求
# AI 心理学家作为 "assistant",负责提供专业知识和内容
role_play_session = RolePlaying(
assistant_role_name="心理学家",
user_role_name="作家",
task_prompt=task_prompt,
model=model,
with_task_specify=False, # 在本例中,我们直接使用给定的task_prompt
)
print(Fore.CYAN + f"具体任务描述:\n{role_play_session.task_prompt}\n")
# 3、启动并且运行自动化对话
# 开始协作对话
chat_turn_limit, n = 30, 0
# 调用 init_chat() 来获得由 AI 生成的初始对话消息
input_msg = role_play_session.init_chat()
while n < chat_turn_limit:
n += 1
# step() 方法驱动一轮完整的对话,AI 用户和 AI 助理各发言一次
assistant_response, user_response = role_play_session.step(input_msg)
# 检查是否有消息返回,防止对话提前终止
if assistant_response.msg is None or user_response.msg is None:
break
print_text_animated(Fore.BLUE + f"作家 (AI User):\n\n{user_response.msg.content}\n")
print_text_animated(Fore.GREEN + f"心理学家 (AI Assistant):\n\n{assistant_response.msg.content}\n")
# 检查任务完成标志
if "<CAMEL_TASK_DONE>" in user_response.msg.content or "<CAMEL_TASK_DONE>" in assistant_response.msg.content:
print(Fore.MAGENTA + "✅ 电子书创作完成!")
break
# 将助理的回复作为下一轮对话的输入
input_msg = assistant_response.msg
print(Fore.YELLOW + f"总共进行了 {n} 轮协作对话")运行效果
协作任务:
创作一本关于"拖延症心理学"的短篇电子书,目标读者是对心理学感兴趣的普通大众。
要求:
1. 内容科学严谨,基于实证研究
2. 语言通俗易懂,避免过多专业术语
3. 包含实用的改善建议和案例分析
4. 篇幅控制在8000-10000字
5. 结构清晰,包含引言、核心章节和总结

具体任务描述:
为普通大众撰写8000–10000字短篇电子书《拖延症心理学》:实证为本、通俗易懂。结构:引言、成因(认知/情绪/奖励)、动机与决策、习惯形成与干预、实
用策略与练习、三则案例分析、总结与资源。每章含研究引用与可操作步骤。

作家:
Instruction: 请为电子书的“引言”章节撰写一段400–600字的中文草稿...
Input: None

心理学家:
Solution:
草稿:拖延,是指明知应当完成某项任务却反复推迟或回避的行为与内在倾向。它既可以是偶发的时间管理问题...

Next request.

作家:
Instruction: 请把下面的引言草稿修订为一段450–550字的中文文本...
Input: 草稿:拖延,是指明知应当完成某项任务却反复推迟或回避的行为...
.....
LangGraph 是 LangChain 生态 下的扩展框架,核心设计思路区别于对话式智能体框架(AutoGen、CAMEL),它将智能体运行流程抽象为状态机+有向图,依靠状态、节点、边三大核心要素编排工作流,原生支持循环、条件分支,非常适合构建具备反思、迭代修正、人工介入的复杂智能体流程,也是实现可控、可审计智能体应用的主流方案。
LangGraph 所有业务逻辑都围绕全局状态(State)、节点(Node)、边(Edge) 三大基础组件构建,三者配合完成完整工作流编排。
全局状态是贯穿整个图执行流程的共享数据载体,统一存储对话历史、任务信息、中间结果、迭代次数等全流程数据,所有节点均可读取、更新状态。 通常通过 Python TypedDict 定义状态结构,明确数据字段与类型,示例如下:
from typing import TypedDict, List

# 定义全局状态结构
class AgentState(TypedDict):
    messages: List[str]      # 对话历史
    current_task: str        # 当前任务
final_answer: str # 最终答案节点是具体执行单元,本质为普通 Python 函数。接收当前全局状态作为入参,执行 LLM 调用、工具调用、数据处理等逻辑,最终返回更新后的状态。 每个节点职责单一,模块化程度高,典型示例:
# 规划节点:基于任务生成执行计划
def planner_node(state: AgentState) -> AgentState:
    current_task = state["current_task"]
    plan = f"针对任务「{current_task}」生成执行计划"
    state["messages"].append(plan)
    return state

# 执行节点:落地规划内容
def executor_node(state: AgentState) -> AgentState:
    latest_plan = state["messages"][-1]
    result = f"执行计划「{latest_plan}」得到结果"
    state["messages"].append(result)
return state边用于连接节点、定义流程走向,分为两类,也是 LangGraph 实现分支、循环的核心:
条件路由函数示例:
def should_continue(state: AgentState) -> str:
    # 根据消息数量判断流程走向
    if len(state["messages"]) < 3:
        return "continue_to_planner"  # 继续循环
    else:
        state["final_answer"] = state["messages"][-1]
return "end_workflow" # 结束流程定义完状态、节点、边后,通过 StateGraph 组装工作流,编译后即可执行:
from langgraph.graph import StateGraph, END

# 初始化状态图并绑定状态结构
workflow = StateGraph(AgentState)
# 注册节点
workflow.add_node("planner", planner_node)
workflow.add_node("executor", executor_node)
# 设置流程入口
workflow.set_entry_point("planner")
# 常规边:规划 → 执行
workflow.add_edge("planner", "executor")
# 条件边:执行后动态路由
workflow.add_conditional_edges(
    "executor",
    should_continue,
    {
        "continue_to_planner": "planner",
        "end_workflow": END
    }
)
# 编译生成可执行应用
app = workflow.compile()
# 启动运行
inputs = {"current_task": "分析AI行业新闻", "messages": []}
for event in app.stream(inputs):
print(event)以理解-搜索-回答线性问答助手为例,完整演示 LangGraph 落地流程,该案例包含意图解析、联网搜索、结果应答三大环节,同时具备搜索失败降级能力。
GraphElements.py
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage
from tavily import TavilyClient

# 加载 .env 文件中的环境变量
load_dotenv()

# 初始化模型
# 我们将使用这个 llm 实例来驱动所有节点的智能
llm = ChatOpenAI(
    model=os.getenv("LLM_MODEL_ID"),
    api_key=os.getenv("LLM_API_KEY"),
    base_url=os.getenv("LLM_BASE_URL"),
    temperature=0.7
)
# 初始化Tavily客户端
tavily_client = TavilyClient(api_key=os.getenv("TAVILY_API_KEY"))

"""
业务需求:理解用户提出的问题,然后调用网络搜索工具,搜索并总结结果结论,回答用户的问题
理解 (Understand):首先,分析用户的查询意图。
搜索 (Search):然后,模拟搜索与意图相关的信息。
回答 (Answer):最后,基于意图和搜索到的信息,生成最终答案
"""

class SearchState(TypedDict):
    messages: Annotated[list, add_messages]  # 消息列表 add_messages 表示 messages 字段更新时,不用「整表替换」,而是用 add_messages 规则把新消息追加进去
    user_query: str      # 经过LLM理解后的用户需求总结
    search_query: str    # 优化后用于Tavily API的搜索查询
    search_results: str  # Tavily搜索返回的结果
    final_answer: str    # 最终生成的答案
    step: str            # 标记当前步骤


def understand_node(state: SearchState) -> dict:
    """
    节点一:理解用户需求并生成搜索关键字
    """
    user_message = state["messages"][-1].content

    understand_prompt =f"""分析用户的查询:"{user_message}"
    请完成两个任务:
    1. 简洁总结用户想要了解什么
    2. 生成最适合搜索引擎的关键词(中英文均可,要精准)

    格式要求:
    理解:[用户需求总结]
    搜索词:[最佳搜索关键词]"""

    response = llm.invoke([SystemMessage(content=understand_prompt)])
    response_text = response.content

    # 解析LLM的输出,提取搜索关键词
    search_query = user_message # 默认使用原始查询
    if "搜索词:" in response_text:
        search_query = response_text.split("搜索词:")[1].strip()

    return {
        "user_query": response_text,
        "search_query": search_query,
        "step": "understood",
        "messages": [AIMessage(content=f"我将为您搜索:{search_query}")]
    }


def tavily_search_node(state: SearchState) -> dict:
    """
    节点二:使用Tavily API进行真实搜索
    """
    search_query = state["search_query"]
    try:
        print(f"正在使用Tavily API搜索: {search_query}")
        response = tavily_client.search(
            query=search_query, search_depth="basic", max_results=5, include_answer=True
        )
        # response['answer'] 是一个基于所有搜索结果的总结性回答
        if response.get("answer"):
            search_results = response["answer"]

            return {
                "search_results": search_results,
                "step": "searched",
                "messages": [AIMessage(content="✅ 搜索完成!正在整理答案...")]
            }

        # 如果没有综合性回答,则格式化原始结果
        formatted_results = []
        for result in response.get("results", []):
            formatted_results.append(f"- {result['title']}: {result['content']}")
        search_results = "\n".join(formatted_results)

        return {
            "search_results": search_results,
            "step": "searched",
            "messages": [AIMessage(content="✅ 搜索完成!正在整理答案...")]
        }

    except Exception as e:
        # ... (处理错误) ...
        return {
            "search_results": f"搜索失败:{e}",
            "step": "search_failed",
            "messages": [AIMessage(content="❌ 搜索遇到问题...")]
        }


def generate_answer_node(state: SearchState) -> dict:
    """
    节点三:基于搜索结果生成最终答案
    """
    if state["step"] == "search_failed":
        # 如果搜索失败,执行回退策略,基于LLM自身知识回答
        fallback_prompt = f"搜索API暂时不可用,请基于您的知识回答用户的问题:\n用户问题:{state['user_query']}"
        response = llm.invoke([SystemMessage(content=fallback_prompt)])
    else:
        # 搜索成功,基于搜索结果总结答案
        answer_prompt = f"""基于以下搜索结果为用户提供完整、准确的答案:
        用户问题:{state['user_query']}
        搜索结果:\n{state['search_results']}
        请综合搜索结果,提供准确、有用的回答..."""
        response = llm.invoke([SystemMessage(content=answer_prompt)])

    return {
        "final_answer": response.content,
        "step": "completed",
        "messages": [AIMessage(content=response.content)]
    }
Graph.py
from GraphElements import SearchState, generate_answer_node, tavily_search_node, understand_node

from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import InMemorySaver

def create_search_assistant():
    # 1、初始化状态变量 所有节点、边都可以访问
    workflow = StateGraph(SearchState)

    # 2、添加节点
    workflow.add_node("understand", understand_node)
    workflow.add_node("search",tavily_search_node)
    workflow.add_node("answer",generate_answer_node)

    # 3、添加边,设置线性流程
    workflow.add_edge(START,"understand")
    workflow.add_edge("understand","search")
    workflow.add_edge("search","answer")
    workflow.add_edge("answer",END)

    # 4、编译图
    memory = InMemorySaver()
    app = workflow.compile(checkpointer=memory)
    return app
UnitTest.py
from pathlib import Path

from dotenv import load_dotenv
from langchain_core.messages import HumanMessage

from Graph import create_search_assistant

# .env 在 Framework/LangGraph/ 目录
load_dotenv(Path(__file__).resolve().parent.parent / ".env")


def test_search_assistant(question: str) -> dict:
    """测试搜索助手完整流程:理解 → 搜索 → 回答"""
    app = create_search_assistant()
    config = {"configurable": {"thread_id": "test-session-001"}}

    initial_state = {
        "messages": [HumanMessage(content=question)],
        "user_query": "",
        "search_query": "",
        "search_results": "",
        "final_answer": "",
        "step": "",
    }

    print("--- 开始测试 LangGraph 搜索助手 ---")
    print(f"用户问题: {question}\n")

    result = app.invoke(initial_state, config=config)

    print(f"搜索关键词: {result.get('search_query')}")
    print(f"\n最终答案:\n{result.get('final_answer')}")

    print("\n--- 测试通过 ---")
    return result


if __name__ == "__main__":
test_search_assistant("黄缘龟苗误食了小的赤玉石,会不会有影响,会有哪些症状?")--- 开始测试 LangGraph 搜索助手 ---
用户问题: 黄缘龟苗如果有肠炎,会有哪些症状?
正在使用Tavily API搜索: 黄缘龟苗 肠炎 症状
搜索关键词: 黄缘龟苗 肠炎 症状
当前步骤: completed
最终答案:
根据搜索结果显示,黄缘龟苗患上肠炎时的典型症状主要包括以下几个方面,供你早期识别参考:
1. **腿部肿胀**:这是较为明显的特征之一,通常表现为前腿或后腿出现肿胀。
2. **食欲减退**:龟苗会变得不爱吃东西,食量明显下降甚至完全拒食。
3. **精神不振**:整体状态萎靡,活动减少,可能长时间趴着不动或闭眼。
4. **四肢无力**:抓握或移动时感觉四肢绵软无力,爬行缓慢或难以支撑身体。
**重要提醒**:
- 发现上述症状后,**建议减少或暂停喂食**,以减轻肠胃负担。
- 如果症状持续或加重(如出现拉稀、粪便恶臭、浮水等),应及时咨询专业兽医或资深饲养者,避免自行用药导致风险。
--- 测试通过 ---结合原理与实战,对比对话式框架,总结 LangGraph 的适用场景与短板。